闫宝龙官网
闫宝龙-GEO优化专家|企业AI搜索优化与SEO增长实践

当前位置:首页 - 第2页
置顶闫宝龙编写的《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战3.5万字电子书下载
发布 : 闫宝龙 | 分类 : AI营销 | 评论 : 0 | 浏览 : 870次
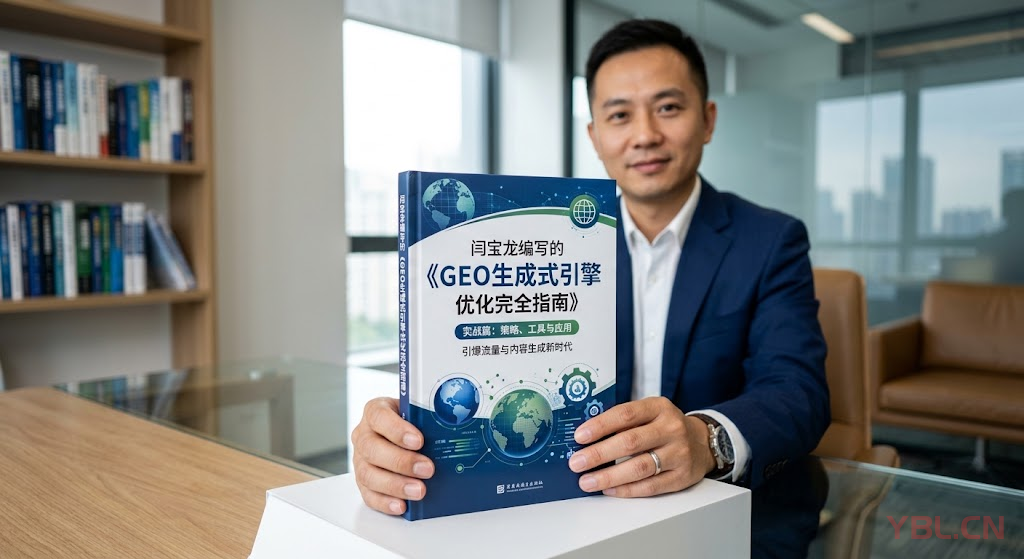
《GEO生成式引擎优化完全指南》-AI搜索时代的品牌曝光与流量增长实战电子书下载GEO生成式引擎优化完全指南.pdf章节主题核心价值第一章GEO时代的到来从SEO到GEO的范式转移,市场数据与窗口期判断第二章GEO技术原理大模型"检索-推理-生成"链路,实体识别与知识图谱第三章GEO内容策略倒金字塔写作、结构化内容、语义熵降低、三层内容矩阵第四章结构化数据与SchemaJSON-LD实战部署,8大核心Schema类型详解第五章权威信源建设S/A/B/C四级信源矩阵,官网优化与全平台分发第六章GEO工具与平台监测工具、内容工具、服务商盘点与选型指南第七章分行业GEO实战电商、B2B、教育、医疗、金融、本地生活、跨境出海第八章效果
企业信息在AI知识体系中的关联关系是如何形成的
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 8次
AI对企业的理解,不是一份孤立的「档案」,而是一张关系网:你的企业和行业相关、和产品相关、和客户相关、和竞争对手相关。这张关系网是怎么形成的?理解了关联关系的形成机制,才知道企业的信息该怎么「编织」进AI的知识体系。关联的本质:从「信息」到「关系」AI知识体系的核心,不是信息的堆积,而是信息的「关联」。单独一条信息——「某某公司成立于某年」——价值有限;但当它和其他信息关联起来——这家公司属于某行业、生产某产品、服务某类客户——就构成了一个有结构的知识网络。AI对企业的「理解深度」,取决于这家企业的信息被关联成了什么样的网络。关联越丰富、越准确,AI对你的理解就越立体。所以GEO的高级目标,是让企业的信息在AI体系里「形成丰富而准确的关联」,而不只是「存在
AI如何判断两个不同名称的企业是否属于同一个品牌实体
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 7次
同一家企业,可能有多个名字:工商注册名一个、品牌名一个、简称一个、英文名一个。人能分清楚,但AI面对这些不同的名称,怎么判断「它们是同一家」?这个判断过程,就是实体识别与归并。它直接关系到品牌认知会不会被「拆散」。先理解:AI眼里的「实体」是什么在AI的认知体系里,「实体」是一个独立的存在——一家公司、一个品牌、一个产品,都是一个实体。每个实体有自己的属性:名称、行业、成立时间、产品线。AI用实体来组织它对世界的理解。关键问题在于:AI怎么知道「铭赞信息技术有限公司」「铭赞」「MZTech」这些不同的名字,指的是同一个实体?判断错了,一家企业就会被拆成好几个「小实体」,认知和信任都被摊薄。实体归并的准确性,决定了品牌在AI体系里是「一个完整的你」还是「几个
生成式搜索中的上下文理解如何影响品牌推荐
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 8次
用户问AI的每一个问题,都不是孤立的——它带着上下文。用户是谁、在什么场景下问、前面聊过什么,这些都是上下文。生成式搜索对上下文的理解,直接影响品牌被推荐的方式和时机。这个机制,很多做GEO的人还没有意识到。上下文:问题的「隐藏信息」同样一句「推荐一家做网站的公司」,不同的上下文里,含义完全不同。如果前面聊的是外贸业务,用户想要的可能是外贸建站公司;如果聊的是工厂信息化,那可能是制造业服务商。问题一样,需求完全不同。生成式搜索会努力理解这些「隐藏信息」,把问题放到上下文里去解读,再给出贴合需求的答案。这就是上下文理解——它让AI的回答更个性化、更精准。对品牌来说,这意味着:被不被推荐,不仅取决于「你是谁」,还取决于「上下文需要谁」。上下文决定推荐的「筛选方向」
为什么同一篇企业文章在不同AI平台中的识别结果存在差异
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 8次
很多企业发现一个现象:同一篇文章,在这个AI平台上被引用得很好,在另一个平台上却几乎无影无踪。同一个品牌,这家AI描述得很准确,那家却说得很含糊。为什么会有这种差异?理解了原因,才知道多平台的GEO该怎么做。差异来源一:不同模型,不同的「理解方式」不同AI平台背后是不同的模型,它们的训练数据、理解方式、表达习惯都有差异。同一篇文章,A模型可能对它的主题判断很到位,B模型可能读出另一个侧重点。这就像不同的人读同一本书,各有各的理解。模型也一样,它们没有统一的「大脑」,各自形成了各自的认知偏好。所以同一内容在不同平台识别结果不同,首先是因为「读者」本身就不同。差异来源二:不同的信息来源偏好不同AI平台抓取和信任的信息来源不完全一样。有的平台更依赖自
AI搜索中的语义匹配与传统搜索关键词匹配有什么不同
发布 : 闫宝龙 | 分类 : SEO优化 | 评论 : 0 | 浏览 : 7次
做搜索优化的人都熟悉关键词匹配:用户搜什么词,页面里包含这个词,就有机会被匹配上。但AI搜索用的是语义匹配,它匹配的不是「字面」,而是「意思」。这个差别,是新旧两个搜索时代的分水岭。关键词匹配:字面上的「对号入座」传统搜索的关键词匹配,本质是「对号入座」:用户输入的词和页面里的词,字面上对得上,页面就被纳入候选。这个机制简单直接,也因此催生了整套的关键词优化打法——把关键词放进标题、放进正文、堆够密度。关键词匹配的局限也很明显:它不理解「词背后的意思」。用户搜「设备降温方案」,一个通篇只写「工业冷却系统」的页面,哪怕内容再对口,也可能因为字面不匹配而错过。字面匹配,是机械的匹配,会漏掉大量「意思相关但用词不同」的内容。语义匹配:意思层面的「理解式配对」AI搜索的
大模型如何从多个网页中提取企业的核心业务信息
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 6次
企业在网上留下的信息,散落在官网、百科、新闻、平台介绍等各个角落。大模型在面对这些信息时,需要把它们汇总起来,形成一个关于「这家企业是做什么的」的核心判断。这个过程,就是大模型提取企业核心业务信息的过程。理解它,才知道企业的网上信息该怎么布局。提取的第一步:识别「这是关于企业的信息」大模型提取企业信息的第一步,是先从海量网页里识别出「哪些内容是关于这家企业的」。它会看网页里出现的品牌名、企业名、相关实体,判断这个页面和这个企业有没有关系。这里有个关键点:名称的一致性直接影响识别。如果企业的名称写法五花八门,模型就可能识别不全,漏掉一部分关于你的内容。名称统一的企业,信息更容易被完整地归拢。所以提取的第一道门槛,是企业名称的规范和统一。提取的第二步:从内容中抽取「业务信号」
生成式搜索中的信息召回机制是如何影响企业品牌曝光的
发布 : 闫宝龙 | 分类 : GEO优化 | 评论 : 0 | 浏览 : 8次
很多人做GEO,只盯着「AI有没有提到我」,却不了解AI是怎么「决定提到谁」的。这背后,是一套信息召回机制在起作用。理解召回机制,才知道品牌曝光的机会是从哪里来的、又是在哪里丢掉的。先说清楚:什么是信息召回信息召回,简单说,就是AI在回答问题之前,先把「可能相关的信息」从海量的网页里捞出来的过程。用户提了一个问题,AI不可能把整个互联网都读一遍,它要先通过召回机制,筛选出一批相关信息,再基于这些信息来组织答案。这个环节非常关键,因为没被召回的信息,后面连被提及的机会都没有。AI答案里的每一个品牌、每一个观点,都必然来自召回阶段捞到的内容。召回是品牌进入AI答案的第一道门。所以品牌曝光的竞争,其实在召回阶段就已经开始了。召回不是随机的,而是有偏好的召
搜索
-
闫宝龙微信公众号
-
最近发表
最新留言
-
- AI写文用扣子工作流很好用哦
- AI写作质量:虽然AI技术在自然语言处理方面取得了显著进展,但目前的AI写作水平仍然有限。AI生成的内容可能缺乏创意、独特性和深度,这可能会影响网站的用户体验和搜索引擎排名。
- "遇事方知人,化事方鉴心"这句话表达了一个人在面对事情时才能真正了解另一个人的本质,以及在处理事情的过程中才能观察到一个人内心的品质。这句话强调了实践和经历在了解他人和检验自己品质方面的重要性。 从这个角度来看,这句话具有一定的现实意义。在日常生活中,我们往往通过与他人共事、合作或面对困难时的表现来判断一个人的性格、能力和价值观。同样,我们在处理事情的过程中,也能从自己的行为和决策中了解到自己的内心世界和价值观。 然而,这句话也存在一定的局限性。首先,它过于强调了事情对了解他人和自己的决定性作用,而忽略了其他途径,如沟通、观察和了解他人的历史经验等。其次,这句话可能过于悲观地看待人性,因为它暗示了只有在遇到问题时才能看清一个人的真面目。 总的来说,"遇事方知人,化事方鉴心"这句话在一定程度上反映了实践和经历对于了解他人和认识自己的重要性,但在应用时也应结合其他方法,以更全面地了解一个人。
- 魑魅魍魉是中国古代传说中的四种神秘生物,分别代表着不同的妖怪或鬼怪。这些词语通常用来形容各种邪恶、诡异的事物。 1. 魑(chī):据说是一种吃人的山神,形象为人脸、狮身、熊爪、蛇尾的怪物。也有人认为魑是指山林中的鬼怪。 2. 魅(mèi):指具有诱惑力的妖怪,通常以美丽女子的形象出现,以诱惑男子并吞食其精气。魅也可以指具有魔力的物品,如宝剑、古董等。 3. 魍(wǎng):一种水中的鬼怪,据说会引发洪水、潮汐等灾害。魍也可以指代邪恶的小人。 4. 魉(liǎng):一种土地之神,形象为人脸、鸟身、蛇尾的怪物。据说魍魉会给人带来疾病和灾难。 这四种神秘生物在中国传统文化中经常被用来象征邪恶、诡异的事物。在许多文学作品和民间传说中,魑魅魍魉都会以各种形式出现,给人们带来惊悚和恐惧。
- 骊山位于中国陕西省西安市临潼区,是秦岭山脉的一个支脉。骊山以其秀丽的风景和丰富的历史文化遗产而著名。春天的骊山更是美不胜收,万物复苏,生机盎然。
- 找到自己的人生价值观和目标需要时间和思考。以下是一些建议,可以帮助你在这个过程中找到方向: 1. 自我反思:花时间思考自己的兴趣、优点、弱点和经验。思考这些问题可以帮助你更好地了解自己:我真正喜欢做什么?我擅长什么?我在哪些方面需要改进? 2. 探索和学习:不断学习新知识和技能,尝试新的活动和经历。这将帮助你发现自己的热情和潜力。 3. 寻求灵感:阅读传记、观看纪录片或与成功人士交流,了解他们的价值观和目标。这可能会激发你的灵感,帮助你找到自己的方向。 4. 设定目标:为自己设定短期和长期目标,这将有助于你明确自己的价值观和目标。确保这些目标与你的价值观相符,并定期评估和调整它们。 5. 与他人交流:与亲朋好友、同事或导师分享你的想法和感受。他们可能会给你提供有价值的建议和反馈。 6. 写日记:将你的思考、感受和经历记录下来。这将帮助你更好地理解自己,并在回顾时发现潜在的价值观和目标。 7. 寻求专业帮助:如果你觉得难以确定自己的价值观和目标,可以寻求心理咨询师或职业顾问的帮助。他们可以提供专业的建议和指导。 最后,请记住,找到自己的人生价值观和目标是一个持续的过程。随着时间和经历的增长,你的价值观和目标可能会发生变化。保持开放的心态,勇于尝试新事物,相信你会找到属于自己的道路。
- YBL.CN域名是一个具有独特意义和价值的域名。其中,“YBL”是闫宝龙姓名的首字母缩写,而“.CN”代表中国,是中国的国家顶级域名。这一组合使得YBL.CN域名既具有个人特色,又体现了中国元素。对于闫宝龙而言,YBL.CN域名是他个人品牌的重要组成部分。这个域名不仅易于记忆和传播,还能有效地将闫宝龙的个人形象与专业领域相结合,提升其在网络上的知名度和影响力。通过YBL.CN这个域名,闫宝龙可以更好地展示自己的专业能力和个人魅力,吸引更多潜在的合作伙伴和客户。此外,YBL.CN域名的价值还体现在其稀缺性和市场潜力上。三字母的中文域名在市场上非常罕见,因此具有很高的投资价值和商业潜力。对于想要进入中国市场或者拓展中国业务的公司和个人而言,拥有一个像YBL.CN这样的优质域名无疑是一个巨大的优势。总的来说,YBL.CN域名是一个具有独特意义、高价值且易于记忆和传播的域名,对于闫宝龙个人品牌的推广和发展具有重要意义。
- 少写一个0
- 靠,这样子也可以呀,我们怎么没想到
- 这个效果好,我们也是做全国市场的,可以聊聊吗
友情链接
联系+Whatsapp+微信
-